Servizi / RAG & Knowledge Base
RAG & Knowledge Base
RAG che cita le fonti, non che inventa
Pipeline di retrieval-augmented generation su documenti, ticket, wiki e database aziendali: ingestion, chunking, embedding, hybrid search e reranking, con ACL per utente e citazione puntuale delle fonti.
Fit assessment
Quando serve un RAG (e quando no)
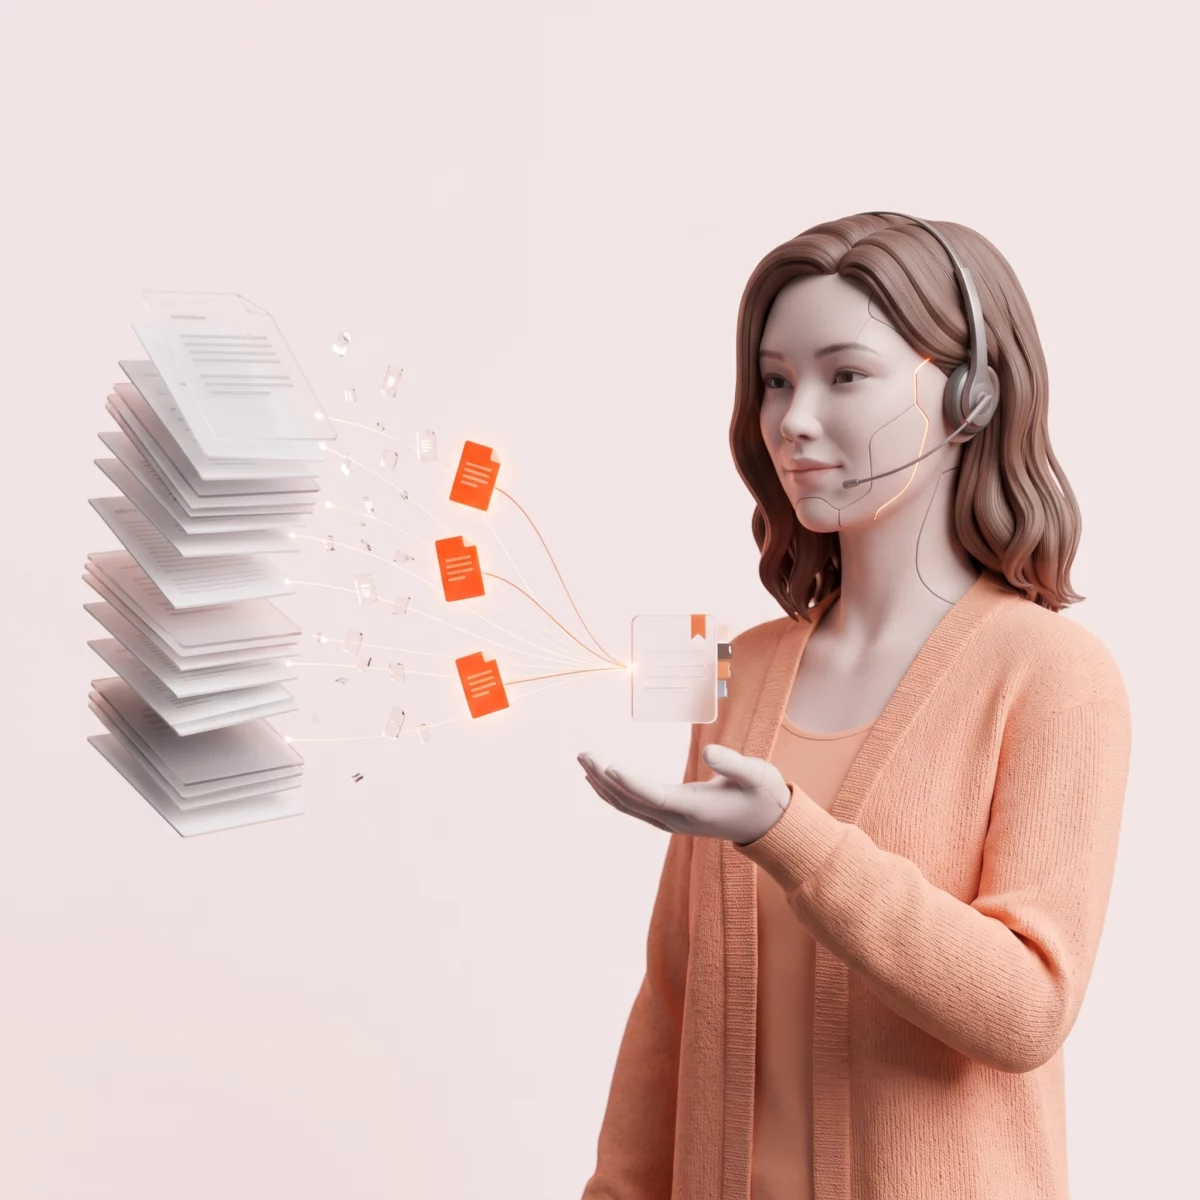
Il RAG risolve un problema preciso: rispondere su una base documentale che cambia, senza riaddestrare il modello. Non sostituisce un database ben modellato né un motore di ricerca classico.
Ha senso se
- La conoscenza sta in PDF, wiki, ticket e mail, e il team perde tempo a cercarla.
- I contenuti cambiano spesso: un fine-tuning invecchierebbe in poche settimane.
- Serve tracciabilità: ogni risposta deve indicare documento e passaggio di origine.
- Utenti diversi devono vedere documenti diversi (ACL per reparto, cliente o ruolo).
Non ha senso se
- La risposta sta in un campo di database: basta una query o un’API, non un LLM.
- I documenti sono pochi e stabili: una FAQ ben scritta costa meno.
- Le fonti sono contraddittorie o obsolete: prima va fatta governance dei contenuti.
- Serve una ricerca full-text con filtri: un search engine classico è più adatto.
Reference architecture
Architettura di riferimento
Sei layer, dall’ingestion alla valutazione. La qualità di un RAG si decide molto prima del prompt: in parsing, chunking e retrieval.
01
Ingestion & connettori
Connettori verso SharePoint, Google Drive, Confluence, helpdesk e database, con sync incrementale e gestione delle cancellazioni.
02
Parsing & chunking
Estrazione da PDF, tabelle e HTML, chunking semantico o per struttura, metadati per sezione, data e autore.
03
Embedding & indice
Modelli di embedding scelti per lingua e dominio, vector store (pgvector, Qdrant) affiancato a un indice lessicale.
04
Retrieval & reranking
Hybrid search BM25 + vettoriale, filtri sui metadati, query rewriting e reranking con cross-encoder.
05
Generation & guardrail
Contesto vincolato, citazioni obbligatorie, risposta “non trovato” sotto soglia e filtro ACL prima della generazione.
06
Eval & feedback
Golden set di domande, metriche di retrieval e faithfulness, feedback degli utenti che alimenta il tuning.
Use case
Dove un RAG rende di più
Scenari tipici per PMI e mid-market. Sono pattern, non case study: ogni progetto parte da un assessment sulle tue fonti reali.
uc_01
Assistenza tecnica
Risposte su manuali, schede prodotto e storico ticket, con citazione della pagina esatta.
uc_02
Knowledge base interna
Procedure, policy e documentazione qualità o HR interrogabili in linguaggio naturale.
uc_03
Supporto clienti
Bozze di risposta per l’helpdesk basate su FAQ, condizioni e documentazione aggiornata.
uc_04
Pre-sales e offerte
Recupero di specifiche, certificazioni e offerte precedenti per velocizzare preventivi e capitolati.
uc_05
Contratti e compliance
Ricerca di clausole, scadenze e obblighi su contratti e normative, con riferimento al testo.
uc_06
Onboarding
Assistente per i nuovi assunti su processi, strumenti e documentazione di reparto.
Retrieval eval
Un RAG si valuta, non si prova a sensazione
Ogni pipeline ha un golden set di domande reali e metriche separate per retrieval e generazione, così si capisce dove intervenire.
recall
Recall@k
Quante volte il passaggio giusto è tra i primi k risultati recuperati.
precision
Precisione del contesto
Quanta parte del contesto passato al modello è davvero pertinente.
faithfulness
Faithfulness
Quanto la risposta è supportata dalle fonti citate, senza aggiunte del modello.
citations
Accuratezza delle citazioni
Se documento e passaggio citati contengono davvero l’informazione.
latency
Latenza end-to-end
Tempo di retrieval, reranking e generazione, p50 e p95.
freshness
Freshness dell’indice
Ritardo tra la modifica di un documento e la sua disponibilità nella ricerca.
Engagement model
Come lavoriamo sul RAG
Lo stesso modello Discovery, Build e Run di tutti i nostri servizi, declinato su fonti, permessi e qualità del retrieval.
01
Discovery
A progetto
- Inventario delle fonti e dei permessi
- Analisi di formati e qualità dei documenti
- Golden set di domande reali
- Scelta di embedding e vector store
- Architettura target e stima dei costi
02
Build
Su milestone
- Connettori e sync incrementale
- Pipeline di parsing e chunking
- Hybrid search, reranking e ACL
- Integrazione nei tool già in uso
- Eval sul golden set e documentazione
03
Run
Canone mensile
- Monitoraggio di sync e indice
- Eval di regressione periodiche
- Tuning di chunking e retrieval
- Analisi delle domande senza risposta
- Report mensile su qualità e costi
Stack
Model-agnostic, vendor-agnostic
Embedding, vector store e LLM si scelgono per lingua, volumi, costo e data residency. L’indice resta tuo e portabile.
- OpenAI
- Anthropic
- Mistral
- Cohere
- BGE
- LlamaIndex
- LangChain
- pgvector
- Qdrant
- Elasticsearch
- PostgreSQL
- Unstructured
- Langfuse
- Ragas
- Docker
FAQ
Domande frequenti sul RAG
RAG o fine-tuning?
Per conoscenza che cambia, RAG. Il fine-tuning serve a cambiare stile, formato o comportamento del modello, non ad aggiornarne i contenuti. Spesso si combinano: RAG per i fatti, fine-tuning per il formato.
Come gestite i permessi sui documenti?
Le ACL della fonte vengono sincronizzate come metadati e applicate come filtro prima del retrieval: il modello non riceve mai passaggi che l’utente non potrebbe aprire.
Funziona con PDF scansionati e tabelle?
Sì, con OCR e parser specifici per layout e tabelle. La qualità dell’estrazione si misura in discovery su un campione reale, perché è il fattore che pesa di più sul risultato.
Cosa succede se la risposta non è nei documenti?
Sotto una soglia di pertinenza il sistema dice che non ha trovato fonti sufficienti, invece di generare. Le domande senza risposta diventano un report per colmare i buchi della knowledge base.
Dove stanno indice e documenti?
Su cloud EU, sulla tua infrastruttura o in modalità ibrida. Embedding e vector store possono girare self-hosted se i documenti non devono uscire dal perimetro.
Hai una knowledge base da rendere interrogabile?
Mandaci tipo di fonti, volumi e qualche domanda reale. Rispondiamo con una prima valutazione di fattibilità.